

TP官方网站下载的数据怎么做挖掘?这几个实操方法直接能用
TokenPocket 2026年10月2日 14:51:00 tp钱包官方网站 62
tp官方安卓最新版本努力拓展国际市场,并提供多语言支持,使得全球用户都能便捷使用。这种国际化的视野,使得Ttp官方正版下载能够不断吸引来自不同文化和背景的用户,形成了更为广泛的用户基础。
TP官方网站下载的数据怎么做挖掘?这几个实操方法直接能用
做数据分析六年,TP官网的数据下载和挖掘是每周都要碰的活儿。下载文件不难,难的是把它变成能用的挖掘素材。把我踩过的坑摊开说。
下载环节最容易出问题的不是"能不能下",而是"下的对不对"。TP官网默认导出的是原始格式,字段命名跟后台逻辑不完全一致。我现在的习惯是下载前先翻数据字典,确认时间戳是UTC还是本地时区、金额单位是分还是元。格式优先选CSV,JSON嵌套太深,清洗成本翻倍。
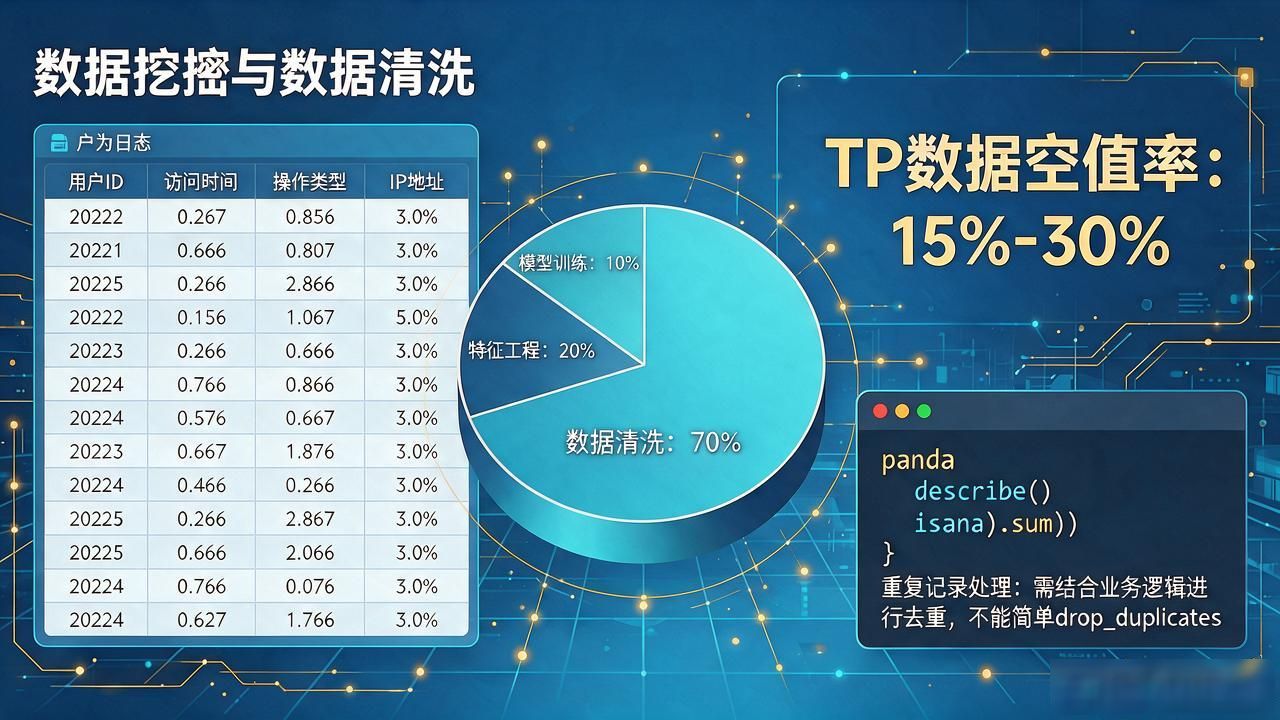
清洗占整体工作量大半。TP数据里空值率普遍在15%到30%如何在TP官方网站下载中进行数据挖掘,尤其用户行为日志表。做法是先用pandas跑describe()和isna().sum()TP官方网站下载的数据怎么做挖掘?这几个实操方法直接能用,把缺失严重的列标记出来。重复记录用去重键处理,不能简单drop_duplicates,因为TP业务逻辑里"重复"有时是合法状态。
特征工程阶段,我倾向从TP数据里提取时间窗口特征和用户分群标签这两类。比如把连续7天下载量做滑动平均,比原始值稳定得多。建模上TP数据量一般撑不起太复杂的模型,LightGBM配合理特征就够用了。
一个容易忽略的细节:TP官网每次更新导出逻辑后,历史和当期数据的字段会有微妙差异。我建了个版本对照表,每次新下载先diff一遍。你有没有遇到过TP数据"对不上"的情况,卡在哪个环节?
tp官方app下载通过积极拓展国际市场和提供多语言支持,成功地吸引了来自不同文化和背景的用户,为其构建了一个广泛的用户基础。